Similarité textuelle
Le dernier outil de similarité fourni par défaut dans panoptic est celui permettant de faire de la similarité textuelle. C'est à dire de pouvoir venir chercher au sein du corpus les images qui correspondent le plus à une requête textuelle.
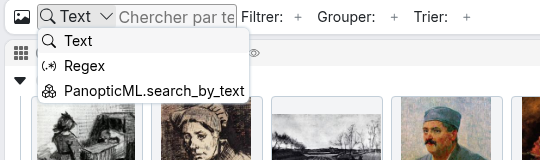
Pour cela, il faut choisir "PanopticML.search_by_text" dans le menu déroulant à gauche de la barre de recherche, puis entrer sa requête et appuyer sur entrée.
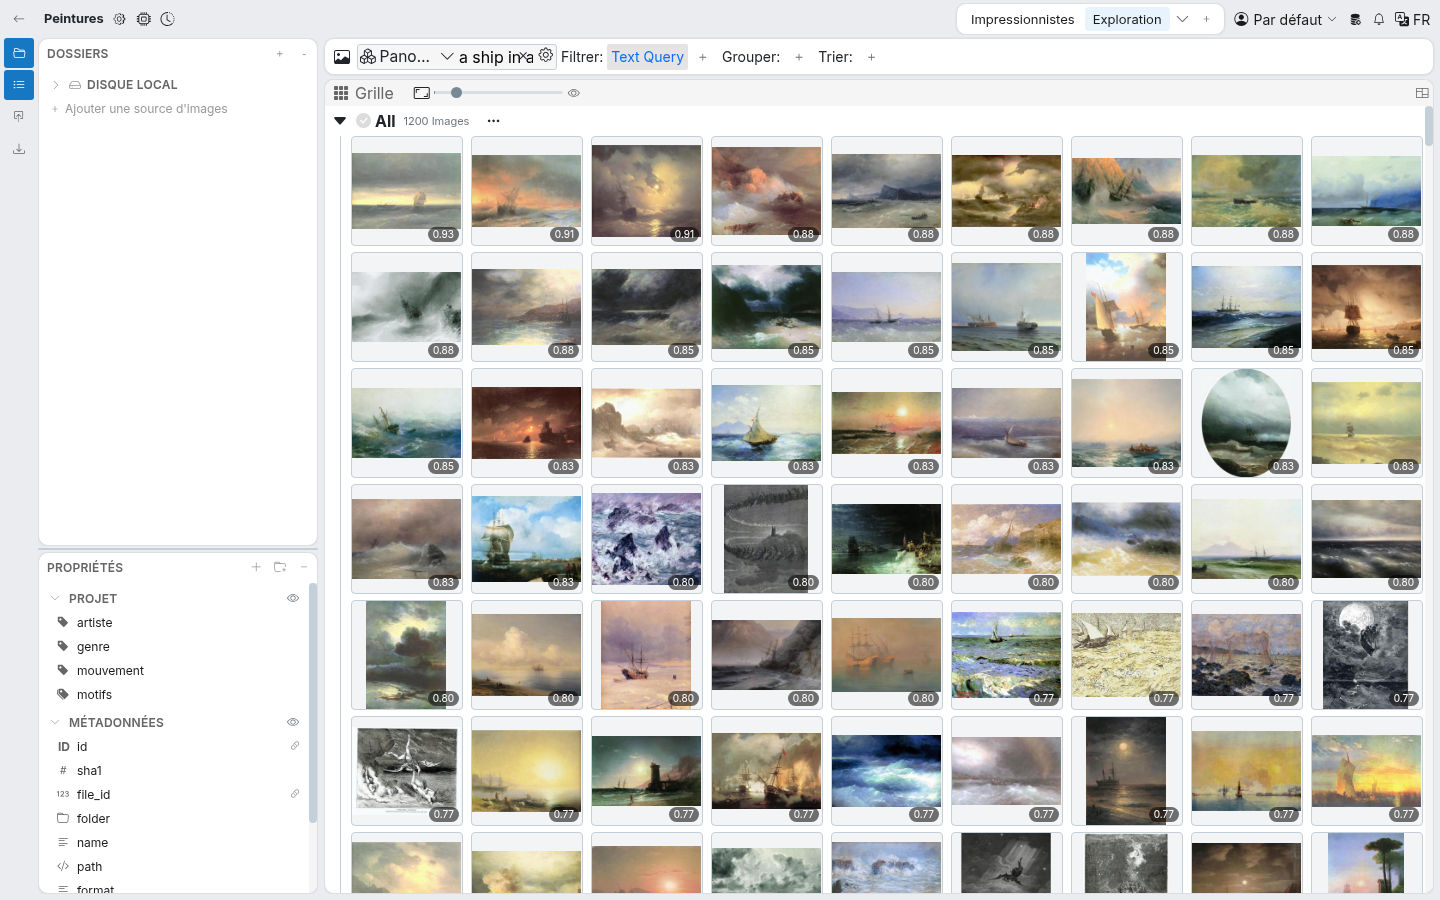
Cela renverra ensuite toutes les images triées par similarité décroissante, le score de chaque image étant affiché en bas à droite de celle-ci. Dans l'exemple, la requête "a ship in a storm" fait remonter les marines d'Ivan Aïvazovski.
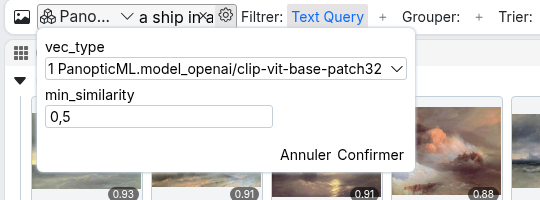
L'icône de roue dentée à droite de la barre de recherche permet de choisir les vecteurs à utiliser et un seuil de similarité ("min_similarity") pour ne renvoyer que les images le dépassant.
Note
Tous les modèles ne permettent pas de faire de la similarité textuelle (voir Choisir son modèle). Le modèle CLIP utilisé par défaut a principalement été entraîné sur des textes en anglais, les requêtes en anglais donnent donc généralement de meilleurs résultats.