Recherche par texte
La recherche par texte permet de retrouver les images qui correspondent le mieux à une description (voir La Similarité Textuelle). Seuls 5 des 9 modèles la permettent : CLIP, MobileCLIP2-S2, MobileCLIP2-L-14, SigLIP2 et EmbeddingGemma 2.
La mesure
Le corpus de 1200 peintures utilisé dans les autres pages s'est révélé trop simple pour départager les modèles : avec seulement 12 artistes, presque toutes les requêtes donnaient de bons résultats. Ce test a donc été réalisé sur un corpus plus grand et plus varié : 10 000 peintures tirées au hasard dans l'ensemble de WikiArt, de toutes les époques et de tous les courants, avec pour chaque image son artiste (lorsqu'il est connu), son genre et son style. Quatre modèles ont été comparés : CLIP, MobileCLIP2-S2, SigLIP2 et EmbeddingGemma 2.
52 requêtes ont été posées à chaque modèle, en anglais puis en français, réparties en cinq familles :
| Famille | Exemples | Vérification |
|---|---|---|
| Artistes (14 requêtes) | "a painting by claude monet", "un tableau de salvador dalí" | artiste de l'image |
| Styles (12 requêtes) | "a cubist painting", "une estampe japonaise", "une peinture pointilliste faite de petits points" | style de l'image |
| Genres (8 requêtes) | "a still life", "une esquisse préparatoire", "une vue de ville" | genre de l'image |
| Couleurs (5 requêtes) | "a black and white image", "un tableau principalement bleu" | couleurs mesurées sur l'image |
| Contenu (13 requêtes) | "a horse", "une femme qui lit un livre", "an old man with a white beard wearing a red hat" | jugement visuel |
Pour les quatre premières familles, on regarde quelle proportion des 30 premières images renvoyées correspond à la requête. Pour le contenu, qu'aucune métadonnée ne décrit, les 10 premières images de chaque modèle ont été examinées une à une, sans savoir quel modèle les avait renvoyées. Les requêtes de contenu vont des plus simples (un objet ou un animal) aux plus complexes (plusieurs personnages, une action, une combinaison d'attributs).
Toutes les requêtes ont été écrites en minuscules, ce qui est important pour SigLIP2 (voir plus bas).
Les résultats
Proportion d'images correspondant à la requête, en anglais / en français :
| Famille | CLIP | MobileCLIP2-S2 | SigLIP2 | EmbeddingGemma 2 |
|---|---|---|---|---|
| Artistes | 65 % / 60 % | 52 % / 45 % | 78 % / 78 % | 61 % / 60 % |
| Styles | 68 % / 57 % | 66 % / 61 % | 82 % / 81 % | 63 % / 62 % |
| Genres | 78 % / 50 % | 70 % / 69 % | 81 % / 72 % | 78 % / 75 % |
| Couleurs | 63 % / 30 % | 62 % / 63 % | 58 % / 53 % | 51 % / 45 % |
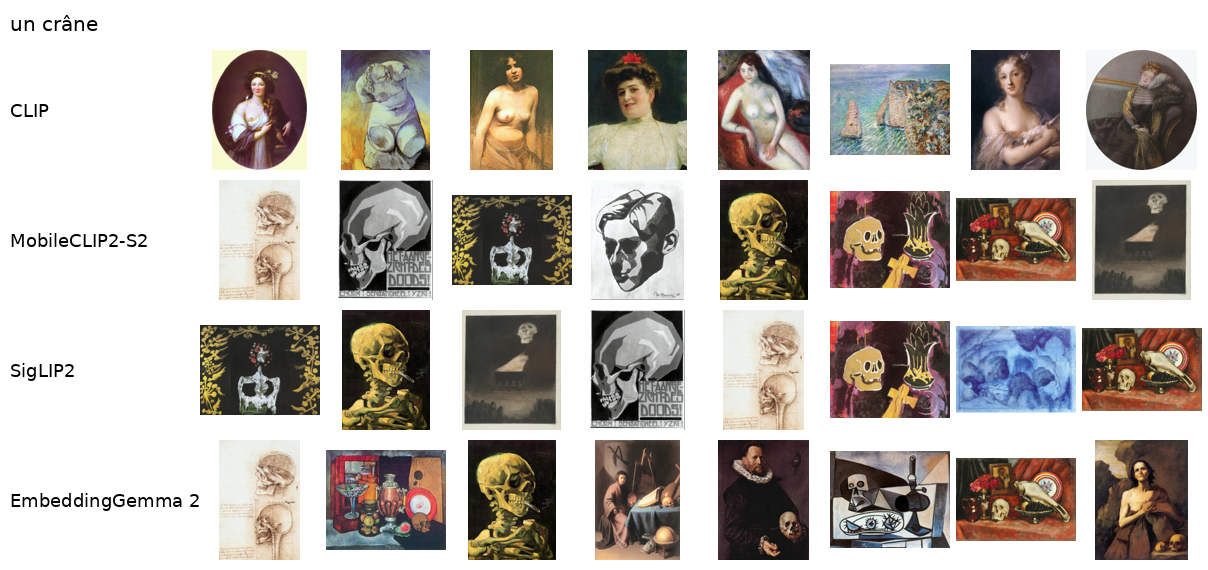
| Contenu | 65 % / 49 % | 65 % / 68 % | 67 % / 69 % | 69 % / 65 % |
| Moyenne | 68 % / 49 % | 63 % / 61 % | 73 % / 70 % | 65 % / 61 % |
Note
Une image sur deux du corpus n'a pas d'artiste renseigné. Une image renvoyée pour "a painting by claude monet" peut donc être un vrai Monet non identifié comme tel, et compter comme une erreur. Les scores des requêtes sur les artistes sont ainsi légèrement sous-estimés, de la même façon pour tous les modèles.
Les connaissances : artistes et styles
C'est sur les noms d'artistes et les styles que les modèles se distinguent le plus. SigLIP2 reconnaît nettement mieux les artistes et les courants artistiques que les autres modèles : parmi les 30 premières images, il retrouve par exemple 100 % de Van Gogh et de Roerich, 90 % de Monet et 96 % de Chagall, Pour les styles, tous les modèles reconnaissent sans difficulté les plus marqués, comme le cubisme ou les estampes japonaises, mais SigLIP2 est le seul à bien identifier des styles moins évidents comme l'art naïf (80 %, contre 40 % au mieux pour les autres modèles), le pointillisme ou la peinture de la première Renaissance. Il garde ce niveau en français.
Les autres modèles ont des connaissances plus inégales : EmbeddingGemma 2 reconnaît très bien Monet, Renoir ou Modigliani, mais presque pas Rembrandt, Dürer ou Doré. MobileCLIP2-S2 est le moins à l'aise avec les noms d'artistes.
Le contenu des images
Lorsque l'on décrit ce que représente l'image, les écarts entre modèles sont beaucoup plus faibles. Tous retrouvent sans difficulté les objets et les scènes simples : un cheval, des fleurs dans un vase, un paysage enneigé, une foule dans une rue. Les résultats se dégradent en revanche pour tous les modèles dès que la requête combine plusieurs éléments :
| Requêtes de contenu | CLIP | MobileCLIP2-S2 | SigLIP2 | EmbeddingGemma 2 |
|---|---|---|---|---|
| simples ("a horse", "a skull", "a snowy landscape"...) | 77 % / 50 % | 82 % / 90 % | 83 % / 87 % | 80 % / 73 % |
| intermédiaires ("a woman reading a book"...) | 80 % / 77 % | 77 % / 80 % | 77 % / 73 % | 73 % / 77 % |
| complexes ("a child holding a dog"...) | 38 % / 28 % | 30 % / 28 % | 35 % / 40 % | 50 % / 45 % |
Avec "an old man with a white beard wearing a red hat", les modèles trouvent bien des vieillards à barbe blanche, mais ignorent presque tous le chapeau rouge. EmbeddingGemma 2 est celui qui tient le mieux compte de ces requêtes composées, sans pour autant les réussir.
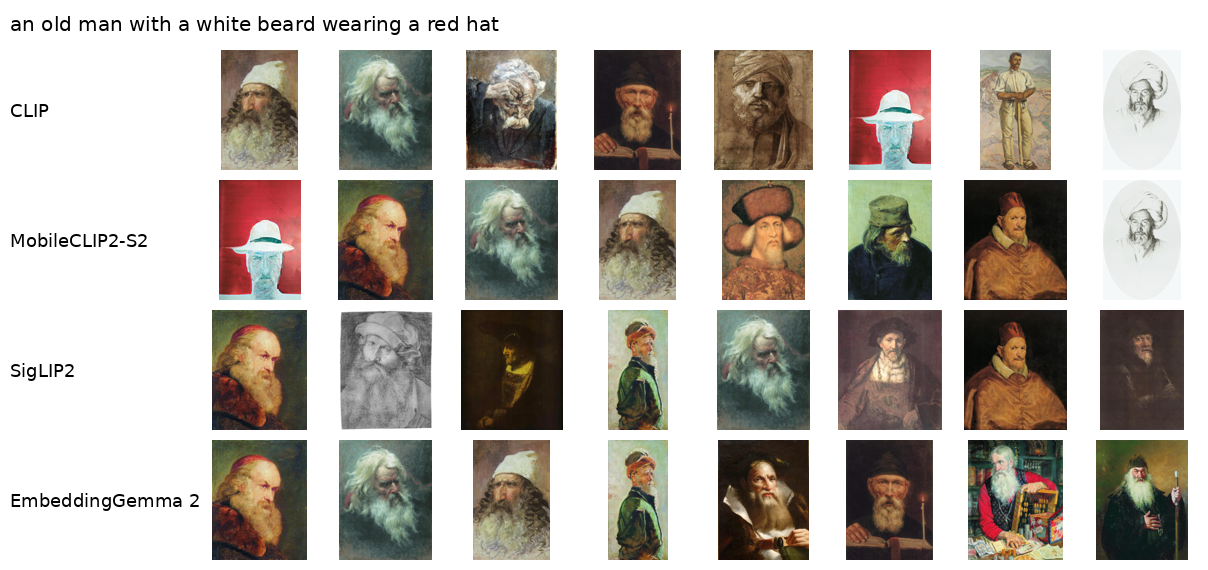
Pour ce type de recherche, il est souvent plus efficace de commencer par une requête simple ("an old man with a white beard"), puis d'affiner à l'oeil ou avec les autres outils de panoptic (images similaires, filtres, annotations).
Les couleurs
Les requêtes portant uniquement sur les couleurs ("un tableau principalement bleu", "une image en noir et blanc") donnent des résultats moyens avec tous les modèles, entre 45 % et 63 %. Les modèles retrouvent des images contenant la couleur demandée, mais pas forcément des images où elle domine. CLIP (en anglais) et MobileCLIP2-S2 sont un peu plus fiables que SigLIP2 et EmbeddingGemma 2 sur ce point.
Les requêtes en français
CLIP a été entraîné presque uniquement sur des textes en anglais. En français, il reste correct sur les noms d'artistes, qui s'écrivent de la même façon dans les deux langues, mais ses résultats s'effondrent sur tout le reste : il ne trouve plus que 30 % d'images de la couleur demandée et la moitié des images correspondant à un contenu, et des requêtes comme "un nu", "une esquisse préparatoire" ou "une peinture naïve" ne donnent presque plus aucun résultat pertinent. "Un crâne" ne renvoie par exemple aucun crâne, mais des portraits et des nus :
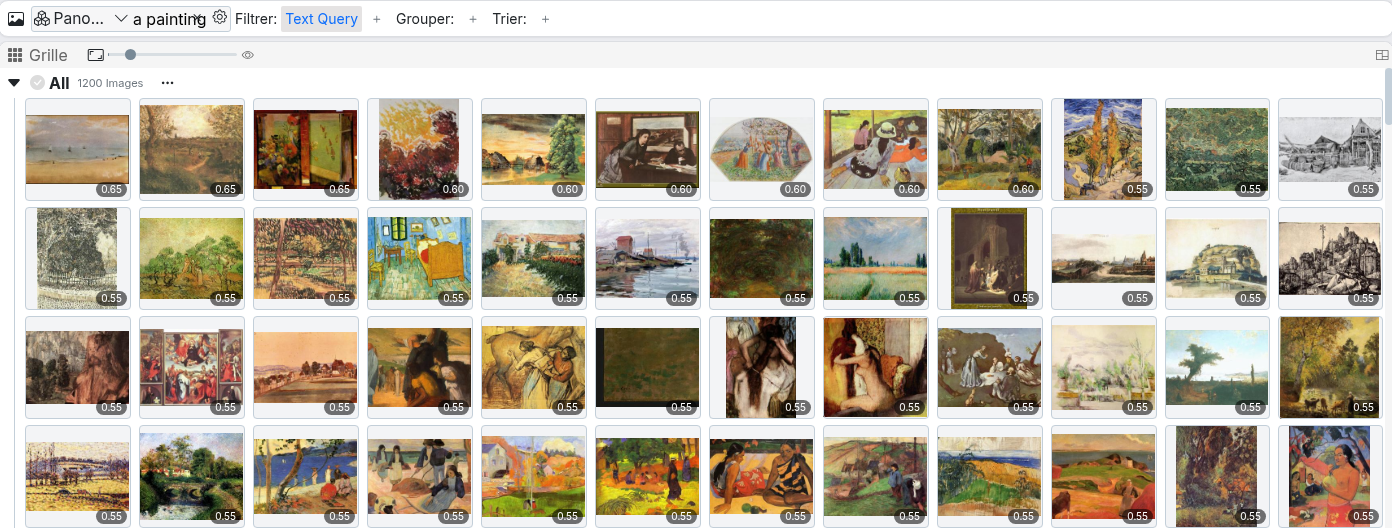
Sur le petit corpus de peintures, "une scène religieuse" renvoie de même des portraits et des paysages avec CLIP, et des crucifixions et des scènes bibliques avec EmbeddingGemma 2 :
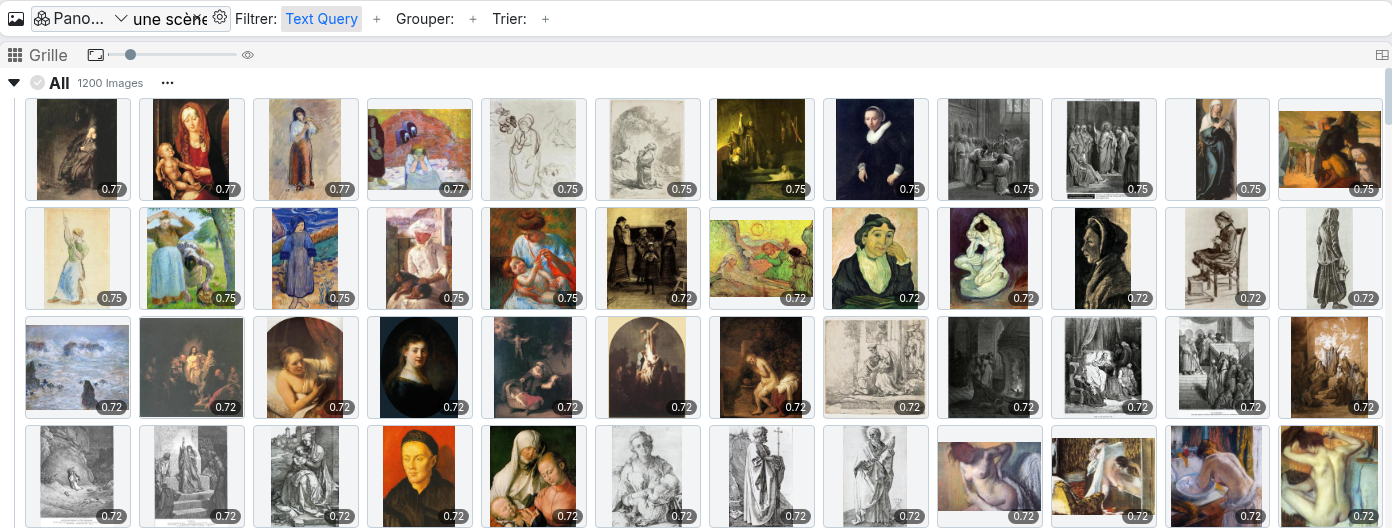
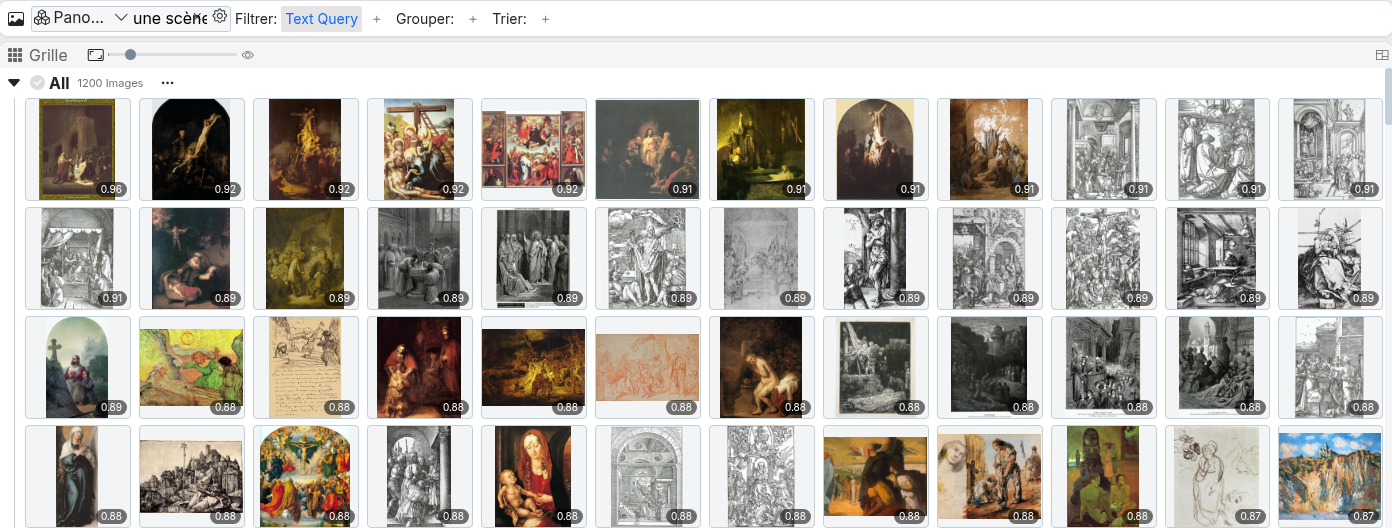
Les trois autres modèles perdent peu de chose en français. Il faut toutefois rester attentif aux mots qui existent aussi en anglais avec un autre sens : EmbeddingGemma 2 comprend "un chat" comme le mot anglais "chat" (une conversation) et renvoie des scènes de café plutôt que des chats.
SigLIP2 et les majuscules
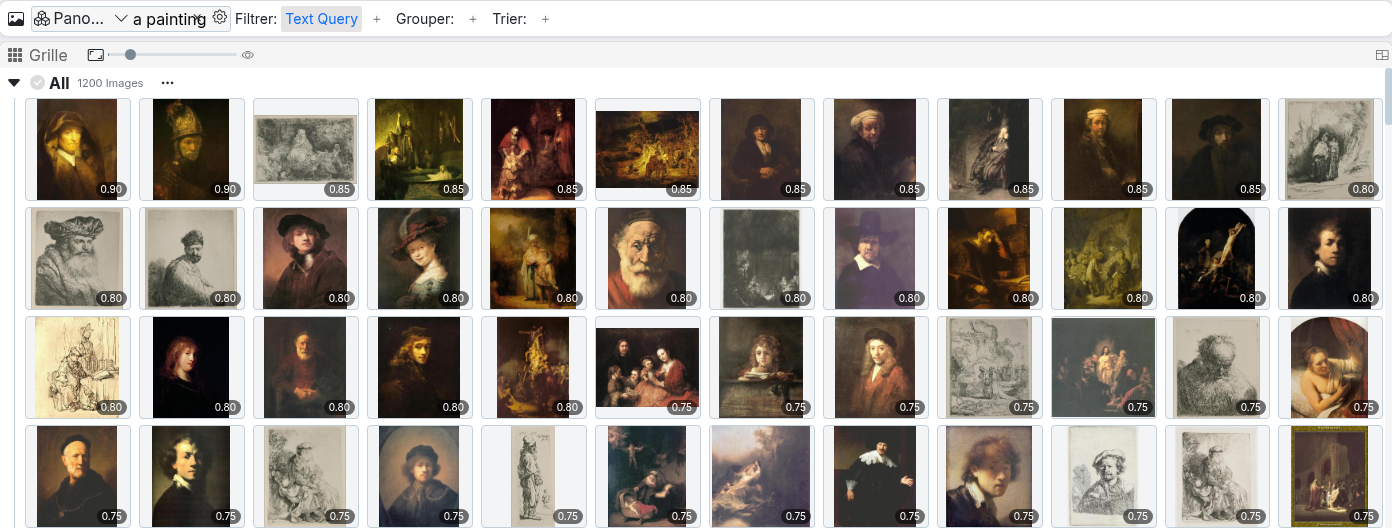
SigLIP2 a été entraîné sur des textes écrits entièrement en minuscules, et il est très sensible à la présence de majuscules dans la requête. Avec "a painting by Rembrandt", aucune des 20 premières images du petit corpus n'est de Rembrandt, alors qu'avec "a painting by rembrandt" elles le sont toutes. Il faut donc toujours écrire ses requêtes en minuscules avec ce modèle, y compris les noms propres. Les autres modèles ne sont pas concernés.
Le seuil de similarité
Le score affiché sous chaque image n'a pas la même échelle d'un modèle à l'autre, ni même d'une requête à l'autre. Avec le seuil "min_similarity" par défaut de 0,5, certaines recherches peuvent ne renvoyer que quelques images, voire aucune, en particulier avec SigLIP2 lorsque la requête contient des majuscules. Il suffit alors de baisser ce seuil dans les paramètres de la recherche (icône de roue dentée à droite de la barre de recherche, voir La Similarité Textuelle).
En résumé
- SigLIP2 est le meilleur choix pour la recherche par texte, en anglais comme en français, surtout pour retrouver un artiste ou un style, à condition d'écrire les requêtes en minuscules.
- EmbeddingGemma 2 est le plus à l'aise avec les descriptions complexes, mais ses connaissances sur les artistes sont inégales et il est beaucoup plus lent à calculer.
- MobileCLIP2-S2 est un bon compromis rapide pour chercher en français, surtout sur le contenu des images.
- CLIP reste efficace en anglais, mais il est à éviter pour les requêtes en français.
- Pour tous les modèles, les requêtes simples donnent de bien meilleurs résultats que les descriptions détaillées.