Doublons proches
Un même document est souvent présent plusieurs fois dans un corpus sous des formes légèrement différentes : une version recadrée, une version compressée récupérée sur un réseau social, une photocopie en noir et blanc, une version avec un logo... Ces images n'ont pas la même signature (sha1) et ne sont donc pas détectées comme des doublons parfaits, mais leurs vecteurs sont très proches. La fonction "PanopticML.find_duplicates" (voir Différentes façons de clusteriser) regroupe les images dont la similarité dépasse un seuil donné, 0,95 par défaut.
Le corpus de test
Le corpus de peintures utilisé dans les autres pages ne contenant pas de doublons, un second corpus a été construit : 300 peintures des mêmes artistes, dont 60 ont été dupliquées 7 fois en leur appliquant une modification différente, soit 720 images au total.
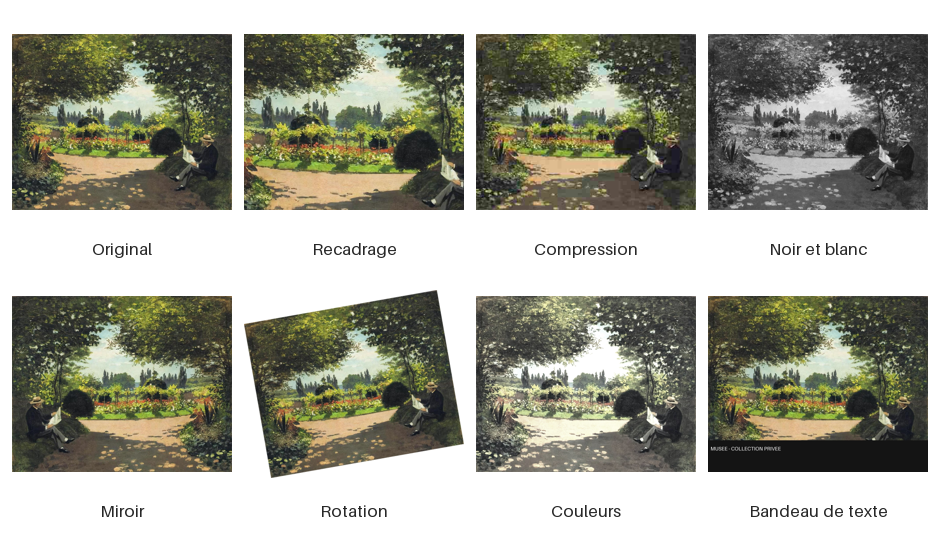
- Recadrage : seuls les 70 % centraux de l'image sont conservés,
- Compression : l'image est réduite au quart de sa taille et fortement compressée,
- Noir et blanc,
- Miroir : l'image est retournée horizontalement,
- Rotation : l'image est tournée de 10 degrés,
- Couleurs : l'image est éclaircie et ses couleurs sont atténuées,
- Bandeau de texte : un bandeau noir contenant du texte recouvre le bas de l'image.
Pour chaque modèle, on regarde si l'image la plus proche de chaque copie est bien une autre version de la même oeuvre, puis quelle proportion des copies est retrouvée selon le seuil de similarité choisi, et combien de paires d'oeuvres différentes sont regroupées à tort.
L'image la plus proche est-elle bien une copie ?
Le tableau indique, pour chaque type de modification, la proportion des copies dont l'image la plus proche est une autre version de la même oeuvre (l'original ou une autre copie).
| Modèle | Recadrage | Compression | Noir et blanc | Miroir | Rotation | Couleurs | Bandeau de texte |
|---|---|---|---|---|---|---|---|
| CLIP | 100 % | 100 % | 100 % | 100 % | 95 % | 98 % | 98 % |
| MobileNet | 100 % | 98 % | 98 % | 100 % | 32 % | 100 % | 100 % |
| MobileCLIP2-S2 | 100 % | 100 % | 97 % | 100 % | 97 % | 100 % | 95 % |
| MobileCLIP2-L-14 | 100 % | 95 % | 97 % | 100 % | 97 % | 100 % | 82 % |
| SigLIP2 | 97 % | 92 % | 98 % | 100 % | 95 % | 98 % | 58 % |
| EmbeddingGemma 2 | 100 % | 95 % | 97 % | 100 % | 98 % | 100 % | 5 % |
| DINOv2 | 100 % | 100 % | 100 % | 100 % | 55 % | 100 % | 100 % |
| DINOv3 | 100 % | 100 % | 100 % | 100 % | 100 % | 100 % | 100 % |
| C-RADIOv4 | 100 % | 97 % | 100 % | 100 % | 97 % | 100 % | 90 % |
Tous les modèles retrouvent sans difficulté les copies recadrées, retournées ou aux couleurs modifiées. Deux modifications font en revanche la différence :
- la rotation : MobileNet et DINOv2 ne retrouvent respectivement qu'un tiers et la moitié des images tournées de seulement 10 degrés,
- le bandeau de texte : EmbeddingGemma 2, et dans une moindre mesure SigLIP2, accordent beaucoup d'importance au texte présent dans l'image. Les copies portant le même bandeau se ressemblent alors davantage entre elles qu'avec leur original, et sont regroupées ensemble. C'est un point à garder en tête pour des corpus contenant des logos, des légendes ou des filigranes, comme des captures de réseaux sociaux.
DINOv3 est le seul modèle à retrouver toutes les copies, quelle que soit la modification.
Le choix du seuil
La fonction "PanopticML.find_duplicates" regroupe les images dont la similarité dépasse le seuil "min_similarity". Le tableau suivant indique, pour plusieurs seuils, la proportion des copies dont la similarité avec leur original dépasse ce seuil, et le nombre de paires d'images d'oeuvres différentes qui le dépassent aussi, et risquent donc d'être regroupées à tort.
| Modèle | Seuil 0,95 | Seuil 0,9 | Seuil 0,85 |
|---|---|---|---|
| CLIP | 35 % (0 erreur) | 75 % (25 erreurs) | 96 % (621 erreurs) |
| MobileNet | 14 % (0 erreur) | 38 % (0 erreur) | 57 % (0 erreur) |
| MobileCLIP2-S2 | 54 % (1 erreur) | 89 % (32 erreurs) | 99 % (187 erreurs) |
| MobileCLIP2-L-14 | 34 % (2 erreurs) | 70 % (34 erreurs) | 95 % (133 erreurs) |
| SigLIP2 | 31 % (8 erreurs) | 74 % (61 erreurs) | 95 % (585 erreurs) |
| EmbeddingGemma 2 | 55 % (8 erreurs) | 77 % (263 erreurs) | 86 % (3313 erreurs) |
| DINOv2 | 60 % (0 erreur) | 79 % (7 erreurs) | 88 % (114 erreurs) |
| DINOv3 | 69 % (3 erreurs) | 93 % (52 erreurs) | 99 % (85 erreurs) |
| C-RADIOv4 | 60 % (25 erreurs) | 87 % (83 erreurs) | 99 % (343 erreurs) |
Avec le seuil par défaut de 0,95, aucun modèle ne retrouve plus de 70 % des copies : ce seuil est prudent et ne regroupe que des images presque identiques. Le baisser à 0,9 permet de retrouver la grande majorité des copies, au prix de quelques erreurs qu'il faudra écarter à la main. En dessous, le nombre d'erreurs augmente très vite pour la plupart des modèles. MobileNet fait exception : il ne commet presque jamais d'erreur, mais il faut descendre le seuil bien plus bas pour qu'il retrouve les copies.
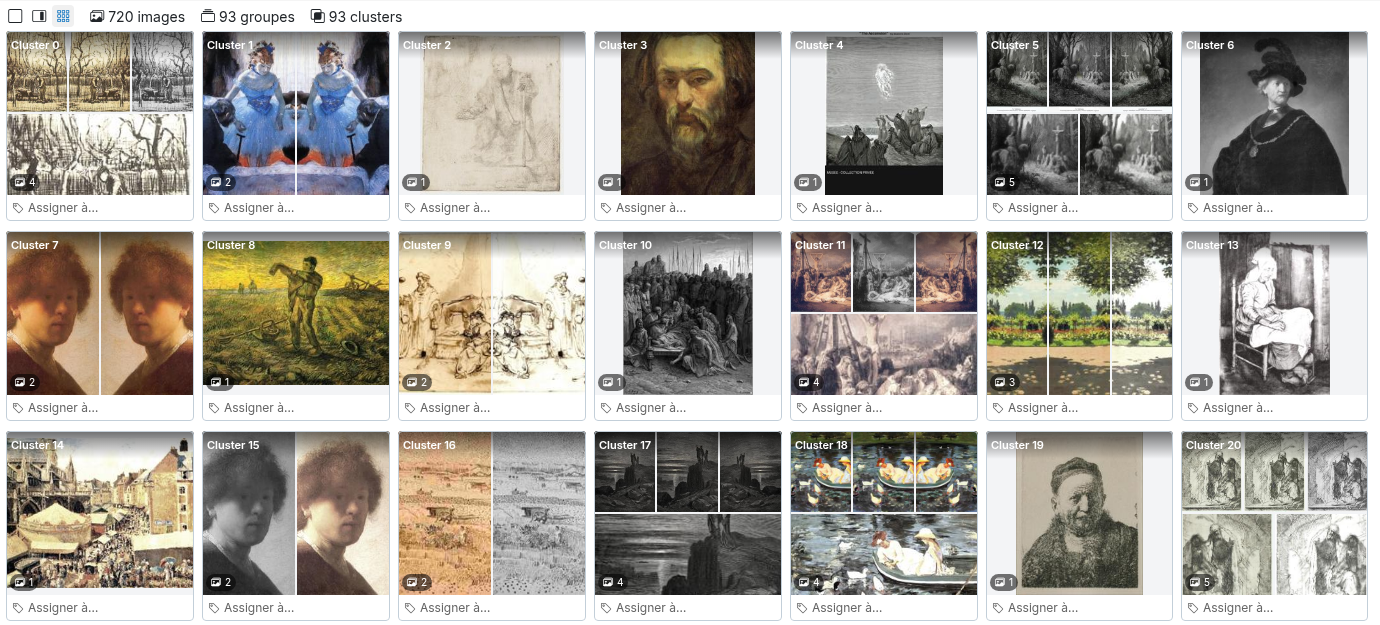
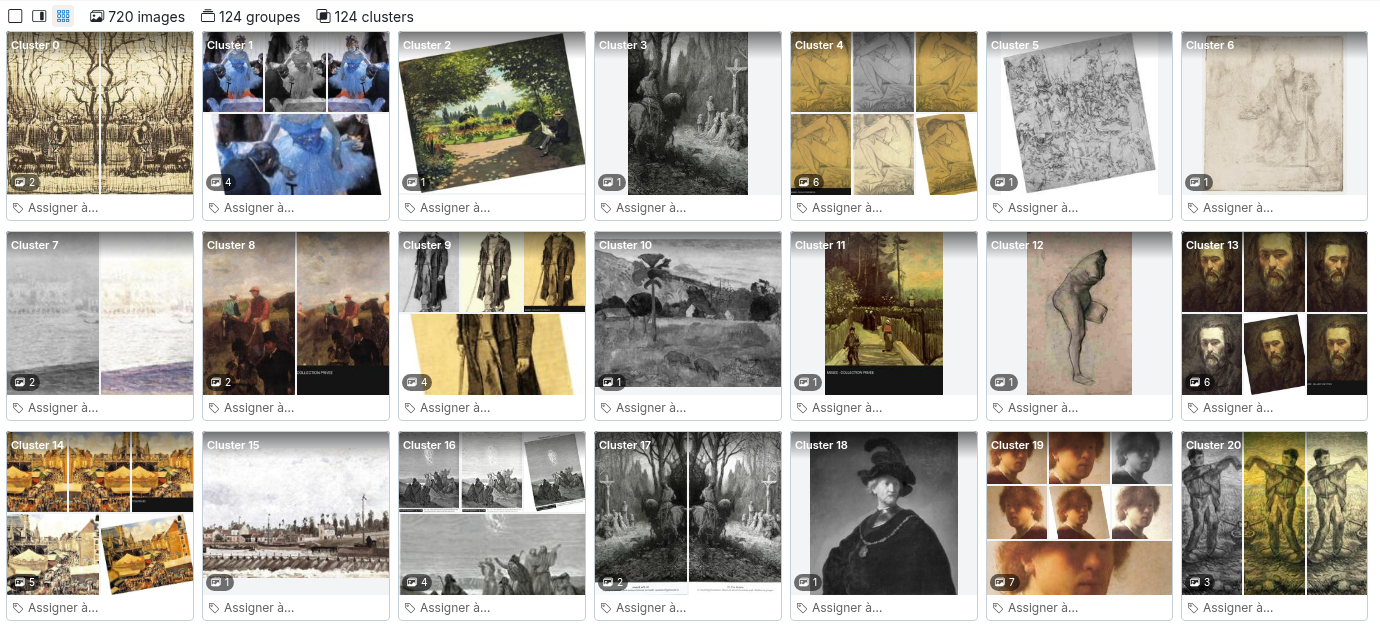
Voici les groupes obtenus avec le seuil par défaut, en vue "Groupée" : CLIP produit 93 groupes, DINOv3 en produit 124 qui réunissent davantage de copies de chaque oeuvre.
Note
Certains groupes ne contiennent qu'une seule image : ses copies ont déjà été rattachées à un groupe formé précédemment. Il suffit de les ignorer.
Doublons ou variantes ?
Une partie des "erreurs" relevées ci-dessus n'en sont pas vraiment. Claude Monet a peint de nombreuses séries sur un même motif, et le corpus contient plusieurs Meules, plusieurs Nymphéas et plusieurs vues de la Cathédrale de Rouen. Ces tableaux sont des oeuvres différentes, mais plusieurs modèles (SigLIP2, C-RADIOv4, DINOv3, EmbeddingGemma 2) les jugent extrêmement proches, parfois davantage qu'une copie tournée ou compressée de la même oeuvre.
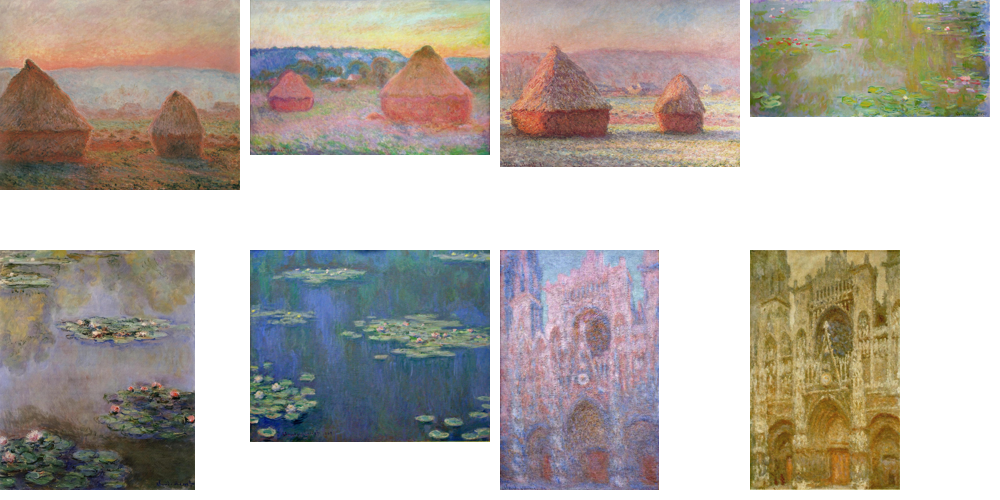
Selon le corpus, ces variantes peuvent être des doublons à écarter ou au contraire des images à étudier ensemble. Dans tous les cas, la détection de doublons est un outil d'aide : il est conseillé de vérifier les groupes proposés avant de supprimer ou d'annoter des images, par exemple en les parcourant dans la vue "Groupée".
En résumé
- DINOv3 est le modèle le plus adapté à la recherche de doublons proches, avec un seuil autour de 0,9.
- DINOv2 et CLIP sont de bonnes alternatives plus légères, à condition que le corpus ne contienne pas d'images tournées pour DINOv2.
- EmbeddingGemma 2 et SigLIP2 sont à éviter lorsque les images contiennent du texte ajouté.