Spatialisation
La vue spatiale place les images sur une carte en deux dimensions à partir de leurs vecteurs (voir Les onglets). Deux images proches pour le modèle doivent se retrouver côte à côte sur la carte : la qualité de la carte dépend donc directement du modèle choisi.
La mesure
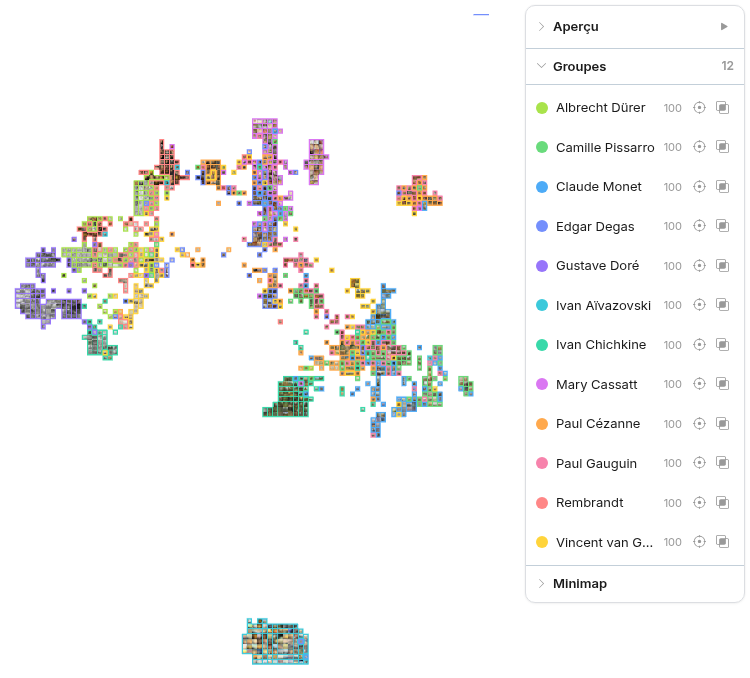
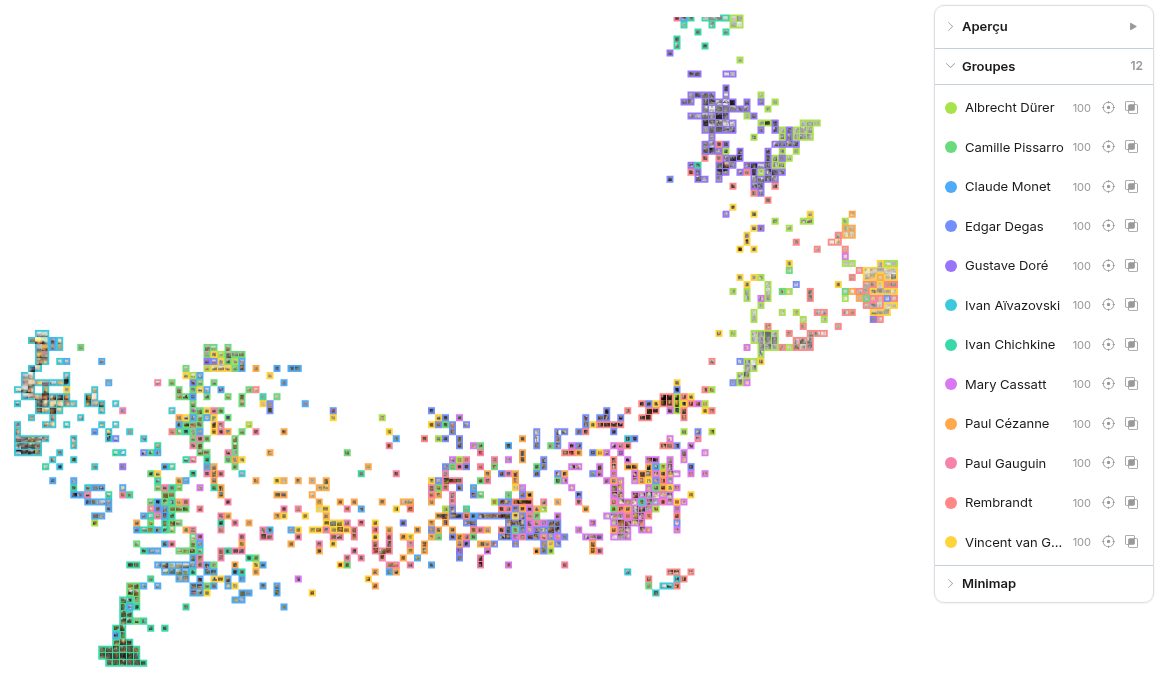
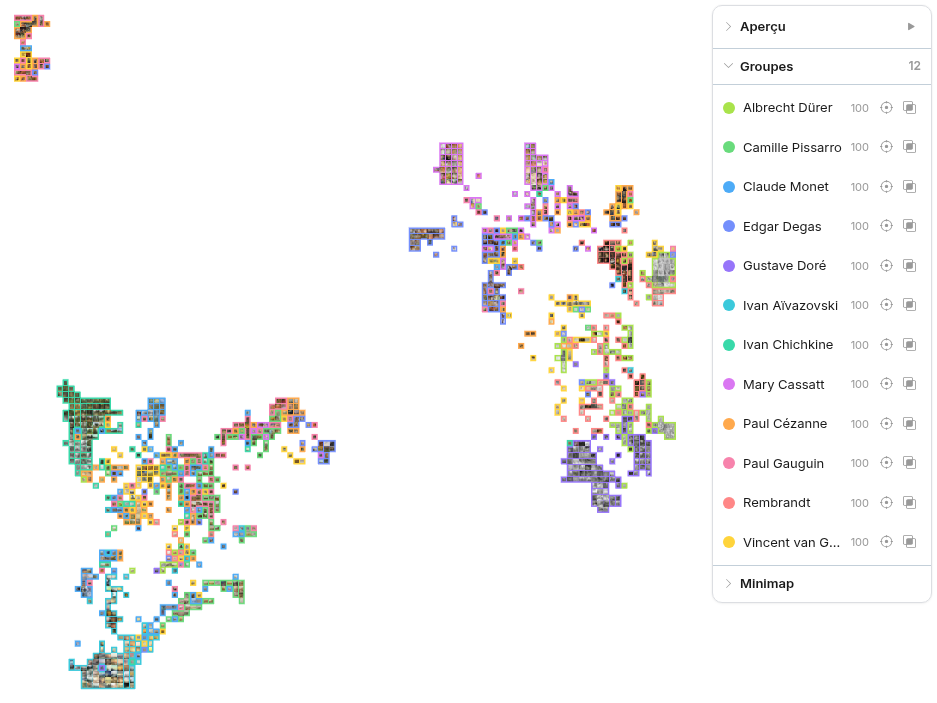
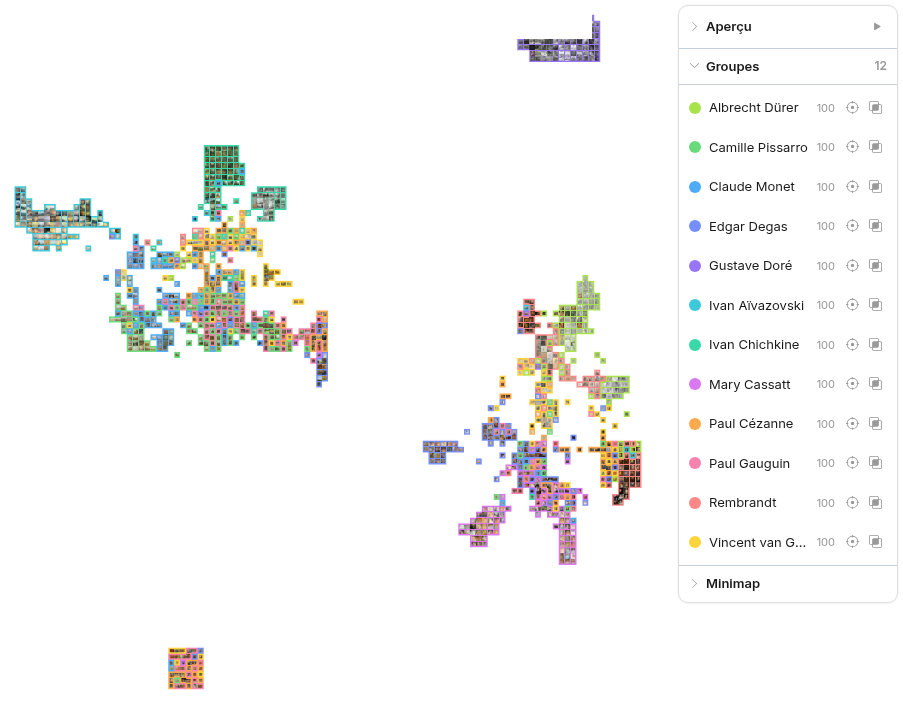
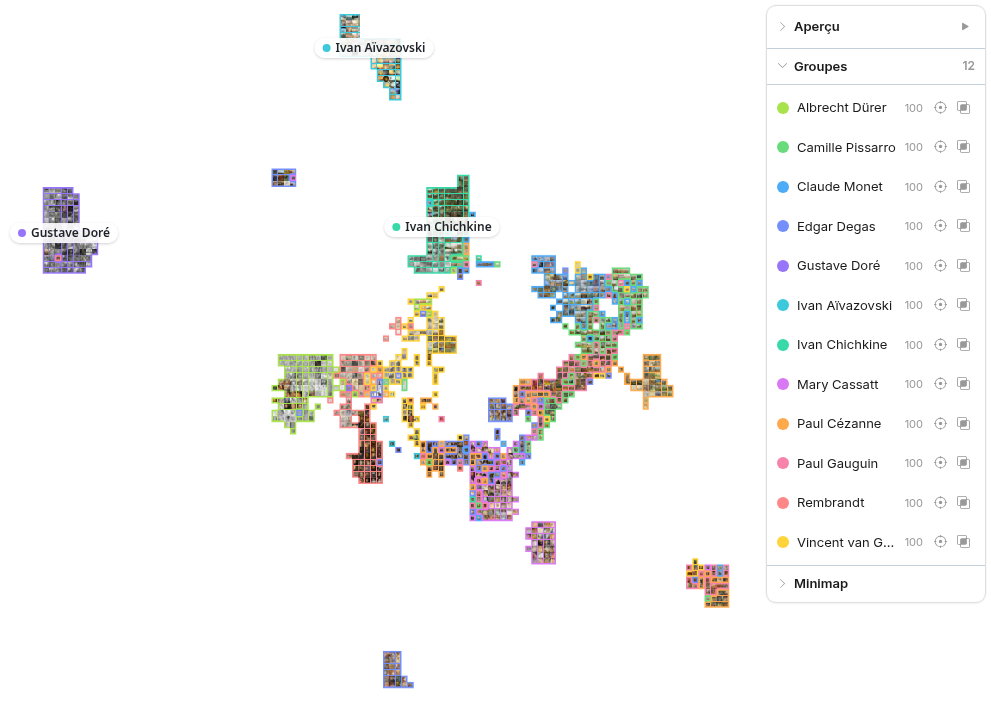
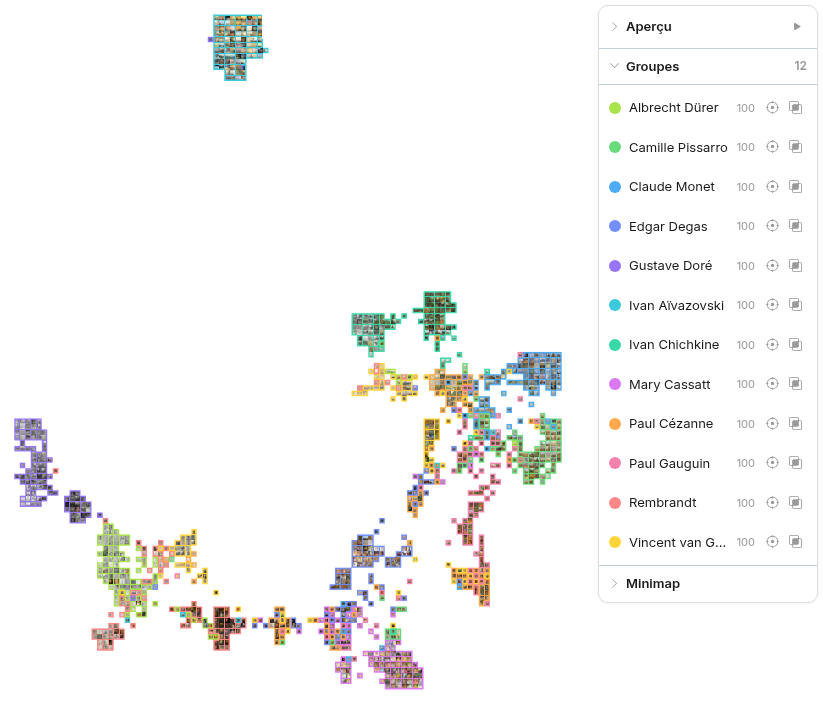
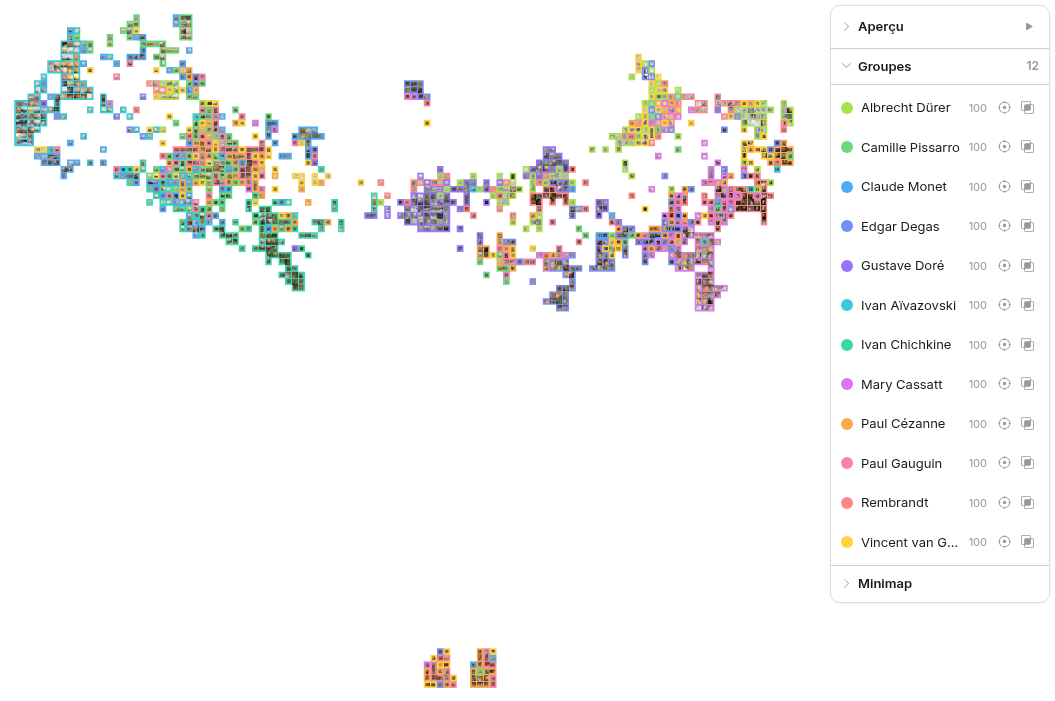
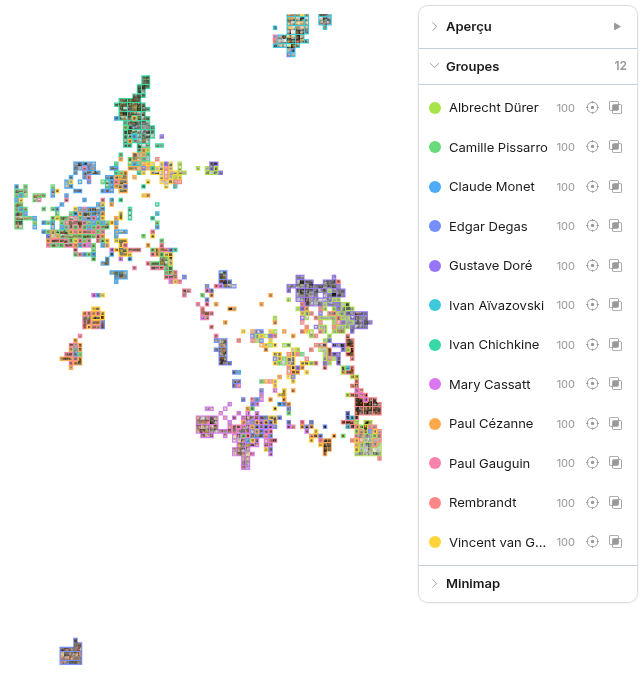
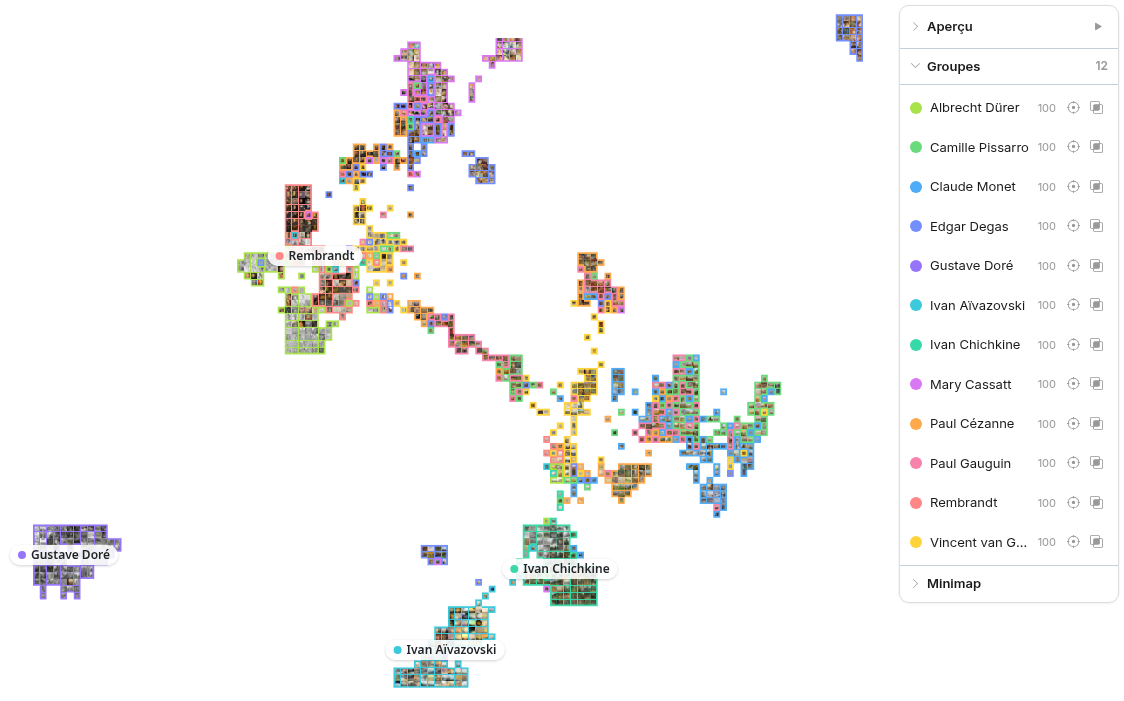
Pour chaque modèle, une carte a été créée avec PaCMAP, puis affichée dans les mêmes conditions :
- images groupées par artiste, chaque artiste ayant sa propre couleur,
- disposition en grille, avec les contours et les noms des groupes,
- curseur "Cases vides entre les groupes" au maximum, pour que les ensembles d'images éloignés sur la carte restent bien séparés.
Avec ces réglages, un artiste dont les oeuvres sont regroupées forme un bloc compact d'une seule couleur, alors que des cases isolées de couleurs mélangées signalent des images placées loin des autres oeuvres de leur artiste.
Deux mesures complètent les captures :
- voisins du même artiste (ou du même genre) : pour chaque image, la proportion de ses 10 plus proches voisines sur la carte qui sont du même artiste (ou du même genre). Plus la valeur est élevée, plus la carte regroupe les oeuvres de cet artiste (ou de ce genre),
- voisinage conservé : la proportion des 10 images les plus proches selon le modèle qui restent parmi les 10 plus proches sur la carte. Passer de centaines de dimensions à deux fait forcément perdre de l'information, cette valeur indique la part qui est conservée.
Les résultats
| Modèle | Voisins du même artiste | Voisins du même genre | Voisinage conservé |
|---|---|---|---|
| CLIP | 60 % | 66 % | 38 % |
| MobileNet | 44 % | 52 % | 25 % |
| MobileCLIP2-S2 | 54 % | 65 % | 39 % |
| MobileCLIP2-L-14 | 63 % | 70 % | 41 % |
| SigLIP2 | 75 % | 69 % | 43 % |
| EmbeddingGemma 2 | 73 % | 61 % | 38 % |
| DINOv2 | 46 % | 60 % | 36 % |
| DINOv3 | 54 % | 64 % | 38 % |
| C-RADIOv4 | 71 % | 68 % | 46 % |
Ce que l'on observe
- SigLIP2, C-RADIOv4 et EmbeddingGemma 2 produisent les cartes les plus lisibles : la plupart des artistes forment des blocs compacts et bien séparés. Gustave Doré, Ivan Aïvazovski, Ivan Chichkine ou Rembrandt se retrouvent presque entièrement isolés, et les impressionnistes (Monet, Pissarro, Cézanne...) occupent une même région de la carte, ce qui est cohérent avec leur proximité de style.
- CLIP et MobileCLIP2-L-14 donnent des cartes un peu moins nettes, où les artistes aux styles marqués restent bien identifiables mais où une large zone centrale mélange plusieurs peintres. Ils regroupent en revanche bien les images d'un même genre (paysages, portraits...).
- DINOv2 et DINOv3 organisent davantage la carte selon ce qui est représenté et la composition de l'image (portraits, bateaux, forêts...) que selon l'artiste : ils sont moins adaptés pour séparer des styles, mais peuvent être utiles pour explorer un corpus par motifs.
- MobileNet produit la carte la moins structurée : la plupart des artistes y sont dispersés et les genres moins bien regroupés qu'avec les autres modèles.
Les couleurs et le contenu
Les mesures précédentes ne s'intéressent qu'à l'artiste et au genre des images. Or les modèles tiennent aussi compte de ce qui est représenté et des couleurs, et une carte peut être cohérente de ce point de vue sans regrouper les artistes.
Pour les couleurs, on a mesuré à quel point les 10 plus proches voisines de chaque image ont des couleurs proches des siennes, par rapport à deux images prises au hasard. Une valeur de 20 % signifie que les voisines sont en moyenne 20 % plus proches en couleur que des images quelconques :
| Modèle | Selon le modèle | Sur la carte |
|---|---|---|
| CLIP | 20 % | 16 % |
| MobileNet | 19 % | 14 % |
| MobileCLIP2-S2 | 18 % | 14 % |
| MobileCLIP2-L-14 | 21 % | 18 % |
| SigLIP2 | 20 % | 17 % |
| EmbeddingGemma 2 | 20 % | 16 % |
| DINOv2 | 16 % | 14 % |
| DINOv3 | 17 % | 14 % |
| C-RADIOv4 | 19 % | 15 % |
Tous les modèles rapprochent les images de couleurs voisines, et ils le font dans des proportions très comparables : sur ce corpus, la couleur ne permet pas de les départager. Contrairement à ce que l'on pourrait attendre, MobileNet n'est pas plus guidé par la couleur que les autres.
Le contenu des images n'est décrit par aucune métadonnée du corpus et n'a pas pu être mesuré directement sur les cartes. On le voit toutefois dans les captures, où les marines, les portraits, les bouquets de fleurs ou les dessins forment des régions bien identifiables, quel que soit le modèle, ainsi que dans la page Clusters. La page Recherche par texte montre aussi que tous les modèles reconnaissent bien les objets et les scènes simples. Ce qui distingue le plus les modèles, c'est leur capacité à reconnaître en plus le style et l'artiste : DINOv2 et DINOv3 regroupent avant tout par motif, alors que SigLIP2, C-RADIOv4 et EmbeddingGemma 2 regroupent aussi par style.
Note
La carte est calculée une seule fois et ne change pas lorsque l'on modifie le groupage ou les filtres. Il est donc possible de créer une carte par modèle dans un même projet et de passer de l'une à l'autre avec le menu déroulant de la vue spatiale pour les comparer, comme dans les captures ci-dessus.